语音识别 从技术原理到日常应用
一、什么是语音识别?
语音识别(Speech Recognition),又称自动语音识别(ASR),是一种让机器通过识别和理解过程,把人类的语音信号转变为相应文本或命令的技术。简单来说,它赋予机器“听懂”人话的能力,是人机交互领域的关键技术之一。
二、核心技术原理
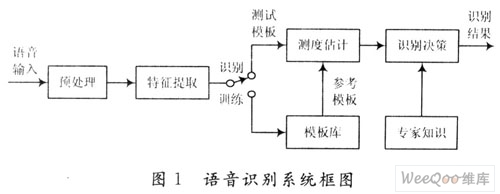
现代语音识别系统通常基于深度学习,主要流程包括:
- 信号预处理:对麦克风采集的原始音频进行降噪、分帧、加窗等操作,提取声学特征(如MFCC、FBank)。
- 声学模型:将声学特征映射为音素或字符概率。早期使用GMM-HMM,如今普遍采用端到端模型(如CTC、Transformer、Conformer)。
- 语言模型:基于大规模文本数据,评估词序列的合理概率,纠正发音相似但语义不符的结果。
- 解码搜索:结合声学模型和语言模型,寻找最优词序列,输出最终文本。
端到端语音识别大幅简化了传统流水线,并在大量数据加持下达到商用级准确率。
三、典型应用场景
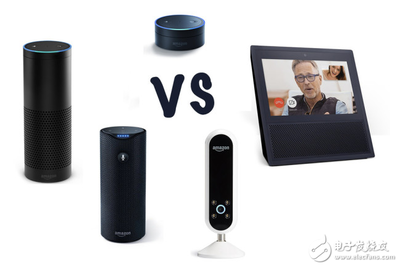
- 智能助手:Siri、小爱同学、天猫精灵等,支持语音控制与问答。
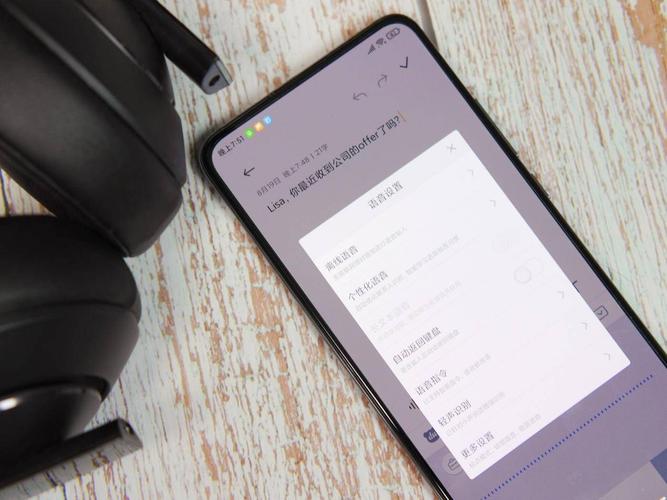
- 语音输入法:讯飞输入法、搜狗输入法等,将说话实时转为文字,提升输入效率。
- 实时字幕:会议、直播、视频平台自动生成字幕,助力无障碍沟通。
- 客服质检:呼叫中心自动转写通话内容,分析情绪与合规性。
- 医疗听写:医生口述病历,系统自动生成电子文档。
- 车载语音:驾驶中通过语音拨号、导航、控车,减少分心。
四、面临的挑战
- 噪声与远场:环境噪声、混响、多人说话会显著降低识别率。
- 口音与方言:不同地区发音差异大,模型泛化能力仍待提高。
- 专业术语:医疗、法律等领域生僻词多,需定制化语言模型。
- 低资源语言:缺少标注数据的语种识别效果差。
- 隐私与安全:语音数据敏感,如何本地化处理和保护用户隐私是重要课题。
五、未来展望
随着自监督学习、多模态融合(语音+视觉+文本)以及大语言模型的发展,语音识别正朝着更高准确率、更强鲁棒性、更低延迟的方向演进。语音识别将更自然地融入物联网、元宇宙、智能座舱等场景,成为人机交互的基础设施。端侧部署与联邦学习有望在保护隐私的前提下实现个性化识别,让每个人都能拥有专属的语音助手。
语音识别,正在让“动口不动手”的智能生活逐步成为现实。
如若转载,请注明出处:http://www.dashuzn.com/product/41.html
更新时间:2026-10-30 01:16:06