电话机器人系统中的TTS语音合成与语音识别应用技术
引言
电话机器人系统是融合通信技术、人工智能与业务场景的典型应用,其核心交互能力依赖两大技术支柱:TTS(Text-to-Speech,文本转语音)语音合成与ASR(Automatic Speech Recognition,语音识别)。两者协同工作,使机器能够“听懂”用户话语并以自然语音“回应”,从而完成外呼营销、客服应答、智能通知等任务。本文将分别探讨这两项技术在电话机器人系统中的实际应用与关键技术。
一、TTS语音合成技术
TTS负责将文本信息转化为流畅、自然的语音信号,是机器人“开口说话”的基础。
1. 技术演进
早期电话机器人采用拼接合成,音质机械、韵律生硬,仅能完成播报。随着深度学习发展,参数合成与端到端神经TTS(如Tacotron、FastSpeech、VITS)逐步成为主流,大幅提升了自然度和表现力,使合成语音接近真人录音。
2. 电话信道下的关键优化
电话语音具有带宽窄(300-3400Hz)、噪声干扰、丢包等特点,TTS需针对性优化:
- 降采样与窄带适配:生成8kHz采样率的语音,匹配电话线路,并通过滤波补偿高频损失,避免声音沉闷。
- 抗丢包与丢帧处理:采用帧重复或预测填充,保证在网络抖动时语音连续。
- 实时性保障:采用轻量化模型和流式合成,首字响应时间控制在200ms内,避免对话卡顿。
3. 情感与自定义音色
电话机器人常需传递不同情绪(如礼貌、热情、安抚)。通过引入情感嵌入向量,TTS可合成带有喜怒哀乐色彩的语音。支持少量样本快速克隆特定音色,帮助企业塑造品牌专属声音形象。
二、语音识别(ASR)技术
ASR负责将用户语音转为文本,是机器人“理解”用户意图的入口。
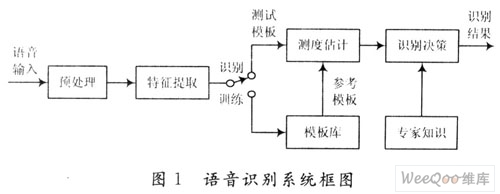
1. 核心流程
电话机器人ASR一般包含:
- 语音活动检测 (VAD):精准分割有效语音与静音/噪声,提升识别效率。
- 声学模型:采用TDNN、Conformer等结构,将声学特征映射为音素或字符概率。
- 语言模型:结合N-gram或神经语言模型,修正语法与语义错误。
- 解码器:通过WFST或CTC/Attention机制输出最优文本序列。
2. 电话场景的挑战与对策
- 8kHz窄带与信道失真:训练数据需混入真实电话录音,并做信道增强和频谱扩展。
- 背景噪声与多人对话:采用降噪算法与说话人分离技术,提高信噪比。
- 口音与方言:通过多口音数据训练及自适应技术,提升泛化能力。
- 实时流式识别:使用流式Chunk或U2++架构,边说边识别,降低延迟。
- 热词与地址识别:动态加载业务热词(产品名、地名),提升特定词汇准确率。
3. 与TTS的协同
ASR识别结果若置信度低,可让机器人通过TTS反问确认,形成多轮交互。TTS播报时需抑制ASR(避免识别自身声音),常用回声消除加能量阈值或半双工机制实现。
三、系统集成与性能要求
| 维度 | TTS要求 | ASR要求 |
|------|---------|---------|
| 延迟 | 首字<300ms,波特率稳定 | 流式响应<500ms |
| 并发 | 支持数千路,资源隔离 | 动态扩容,负载均衡 |
| 容错 | 降级为默认TTS,避免中断 | 置信度阈值过滤,噪声重试 |
实践中,TTS和ASR常部署在GPU/CPU异构集群,利用容器化实现弹性伸缩,配合Kubernetes治理,确保高质量通话体验。
四、未来趋势
- 端到端一体化:TTS与ASR联合建模,实现“听-说”一体化,减少误差传递。
- 低资源与个性化:小样本音色克隆、低资源方言适应。
- 情感识别驱动合成:通过识别用户情绪,动态调整TTS语调,提升共鸣。
- 边缘计算:在网关侧完成部分识别与合成,降低云端依赖。
##
TTS与ASR共同构成电话机器人的语音交互中枢。在窄带、噪声、实时性等严苛约束下,通过深度学习模型优化、缓存策略、流式处理与精准回声消除,二者能够高效协同,支撑智能客服、电销、回访等业务场景。随着大模型与端侧算力发展,电话机器人将更自然、更聪明,成为人机语音沟通的重要桥梁。
如若转载,请注明出处:http://www.dashuzn.com/product/49.html
更新时间:2026-10-30 13:11:19