语音识别软件 从技术原理到日常应用的全面解析
一、什么是语音识别?
语音识别(Speech Recognition),又称自动语音识别(ASR),是一种让计算机“听懂”人类说话的技术。它通过将语音信号转化为文本或指令,实现人机之间的自然交互。简单来说,就是让机器把你说的话变成文字或可执行命令。
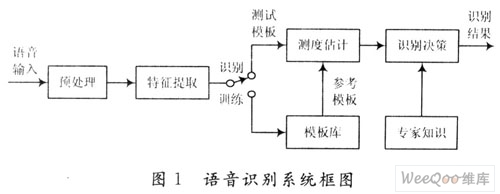
二、语音识别软件的核心技术
现代语音识别软件通常依赖以下几个关键技术:
- 声学模型:将声音信号(波形)映射到音素或子词单元,判断“听起来像什么”。
- 语言模型:基于大量文本学习词语搭配规律,判断“哪些词序更合理”。
- 发音词典:定义每个词的标准音素序列,连接声学与语言层。
- 解码器:搜索最优路径,将声学与语言证据结合,输出最可能的文本。
- 深度神经网络:如RNN、Transformer、Conformer等,大幅提升噪声环境下的识别准确率。
三、主流语音识别软件类型
1. 通用听写工具
- 讯飞听见、百度语音:中文识别率高,支持实时转写、方言(部分)。
- Dragon NaturallySpeaking:英文专业领域老牌软件,医学、法律词典强大。
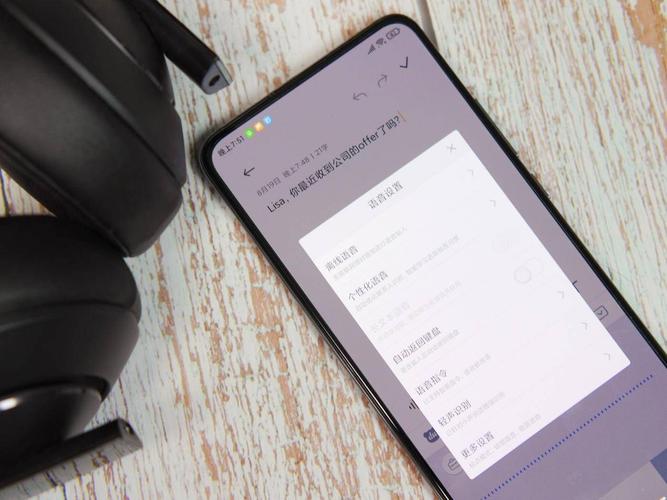
- Windows语音识别 / macOS听写:系统内置,免费易用,适合基础输入。
2. 会议与字幕工具
- 飞书妙记、腾讯会议字幕:实时生成会议记录,区分发言人。
- 剪映、Arctime:视频字幕自动生成,支持时间轴对齐。
3. 开发接口与云服务
- Google Cloud Speech-to-Text、AWS Transcribe、Azure Speech:提供API,支持多语言、定制模型。
- Kaldi、DeepSpeech、Whisper:开源方案,可本地部署,保护隐私。
四、如何选择语音识别软件?
| 考量维度 | 说明 |
|---------|------|
| 识别语言与口音 | 中文、英文、方言、多语种混合 |
| 使用场景 | 个人听写、会议记录、字幕制作、嵌入式设备 |
| 准确率 | 安静环境、嘈杂环境、远场识别能力 |
| 实时性 | 是否需要边说边出字(流式识别) |
| 隐私与部署 | 云端 vs 本地,是否符合数据合规 |
| 价格 | 免费额度、按小时计费、买断制 |
快速建议:
- 日常中文输入:讯飞输入法、搜狗输入法语音版
- 专业英文听写:Dragon、Whisper
- 开发者:OpenAI Whisper + 本地GPU,或云API
- 视频字幕:剪映、网易见外
五、典型应用场景
- 无障碍辅助:为听障人士实时转写对话,为行动不便者提供语音控制。
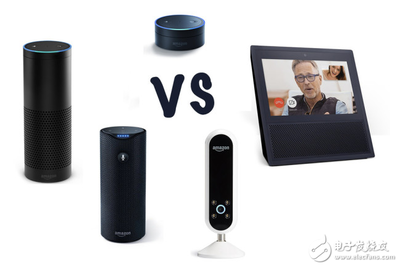
- 智能助手:Siri、小爱同学、Alexa,执行查询、家居控制。
- 医疗与法律:医生口述病历,律师记录庭审,自动生成结构化文档。
- 客服质检:分析通话录音,检测情绪与合规话术。
- 教育:语言学习发音评分,课堂内容转写复习。
六、挑战与未来趋势
尽管语音识别已相当成熟,仍面临以下挑战:
- 噪声与远场:多人交谈、背景音乐下识别率骤降。
- 口音与方言:特定地区或非母语者识别错误率偏高。
- 专业术语:医学、法律、科技词汇常需定制语言模型。
- 隐私安全:云端传输可能泄露敏感对话。
未来趋势:
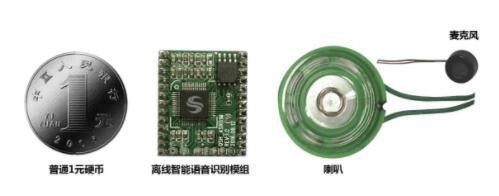
1. 端到端模型:更小、更快、更准,可在手机离线运行。
2. 多模态融合:结合唇读、视觉信息提升嘈杂环境准确率。
3. 语境理解:从“听清”到“听懂”,支持意图识别与对话管理。
4. 个性化自适应:根据用户口音、常用词自动优化。
七、
语音识别软件正在改变我们与设备交互的方式,从简单的听写工具演变为智能助理、无障碍助手和行业效率引擎。无论你是普通用户、内容创作者还是开发者,理解其原理与选型方法,都能帮助你更高效地将“声音”转化为“价值”。下一次你对着手机说话时,不妨想一想背后那一连串精妙的算法——它们正让机器越来越懂你。
如若转载,请注明出处:http://www.dashuzn.com/product/43.html
更新时间:2026-10-30 04:32:26